Bottlenecks & Limits
Ce module, exclusif à OpsBuddy, est votre meilleur allié pour mener une analyse des "Causes Profondes" (Root Cause) lorsque les utilisateurs finaux se plaignent que "SAS est lent".
Il effectue 5 diagnostics agressifs en arrière-plan :
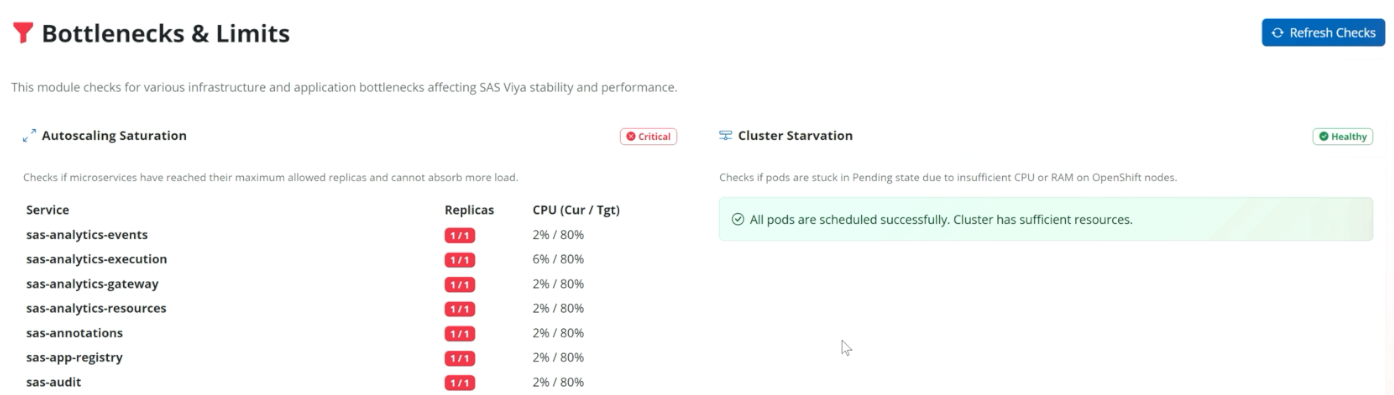
1. Saturation de l'Autoscaling
Vérifie si les services (HPA - Horizontal Pod Autoscaler) ont atteint leur nombre Maximum Replicas ou si leur utilisation du processeur (CPU) dépasse l'utilisation cible.
- Problème : Si
currentReplicas == maxReplicaset que les limites CPU sont saturées, le microservice subit une charge intense et le cluster lui refuse le droit de créer plus de pods pour l'absorber. - Résolution : Modifier la configuration HPA pour augmenter le plafond, ou ajouter du CPU aux pods.
2. Famine du Cluster (Pods en attente)
Vérifie s'il y a un goulot d'étranglement au niveau matériel (OpenShift Nodes).
- Problème : Les pods (par ex., les sessions Compute) sont créés mais restent bloqués dans l'état
Pending. L'outil fournit le message de planification spécifique. - Message typique :
Insufficient cpuouInsufficient memory. Le cluster n'a plus d'espace physique pour accueillir la charge. - Résolution : Ajouter des Worker Nodes au cluster OpenShift (Mise à l'échelle des nœuds).
3. Limites de Mémoire (OOMKilled)
Liste tous les pods qui sont morts en raison d'une limite de mémoire Kubernetes (OOMKilled).
- Problème : Une "Mort Silencieuse". Le pod a essayé d'allouer plus de RAM que son plafond défini. Kubernetes le tue brutalement. L'UI indique le pod, le nombre de redémarrages et la raison.
- Résolution : Côté développeur SAS : optimiser le code (PROC SQL, etc.). Côté administrateur : augmenter les
limits.memorydu pod impacté.
4. Instabilité du Backend
Se concentre sur les Services Core comme PostgreSQL et RabbitMQ.
- Problème : Si RabbitMQ (le bus de messages) ou PostgreSQL plante ou redémarre fréquemment, tous les autres microservices Viya ne peuvent plus communiquer, provoquant des ralentissements erratiques. L'UI met en évidence les échecs de statut et les redémarrages.
- Résolution : Vérifier les journaux RabbitMQ ou PostgreSQL ou redémarrer le statefulset.
5. Routage Réseau (Ingress)
Analyse les journaux du routeur (contour / envoy) à la recherche des codes HTTP 502, 503 et 504.
- Problème : Les requêtes des utilisateurs (via leur navigateur web) n'atteignent pas le pod Viya car elles subissent des délais d'attente (504 Gateway Timeout) ou un rejet (502 Bad Gateway / 503 Service Unavailable).
- Résolution : Souvent lié à des microservices surchargés ou à des délais d'attente d'Ingress trop courts (60s par défaut sur certains clouds).